

開始前準備
請先登入管理帳號, 確認設備已加入且最近仍有收集資料. 先從設備 Health 的 Processor 檢查 CPU 項目. 本篇設定已探索到的 CPU 項目使用率達 80% 時告警. 同一設備可能同時有 Average 與個別核心, 請先決定需要的範圍.
本篇先完成規則, 另需 新增通知聯絡人 與 設定寄信 才能驗證電子郵件送達. 80% 是示例, 請依設備平時使用量調整門檻.
介面核對: 2026-10-02 / Observium CE 26.1.14545. 本文以官方社群版為例, 按鈕保留實際英文名稱. 配圖為操作示意圖, 範例值請按自己的設備替換; 實測範圍及尚未驗證的項目於對應段落說明.
01選擇告警類型與基本設定
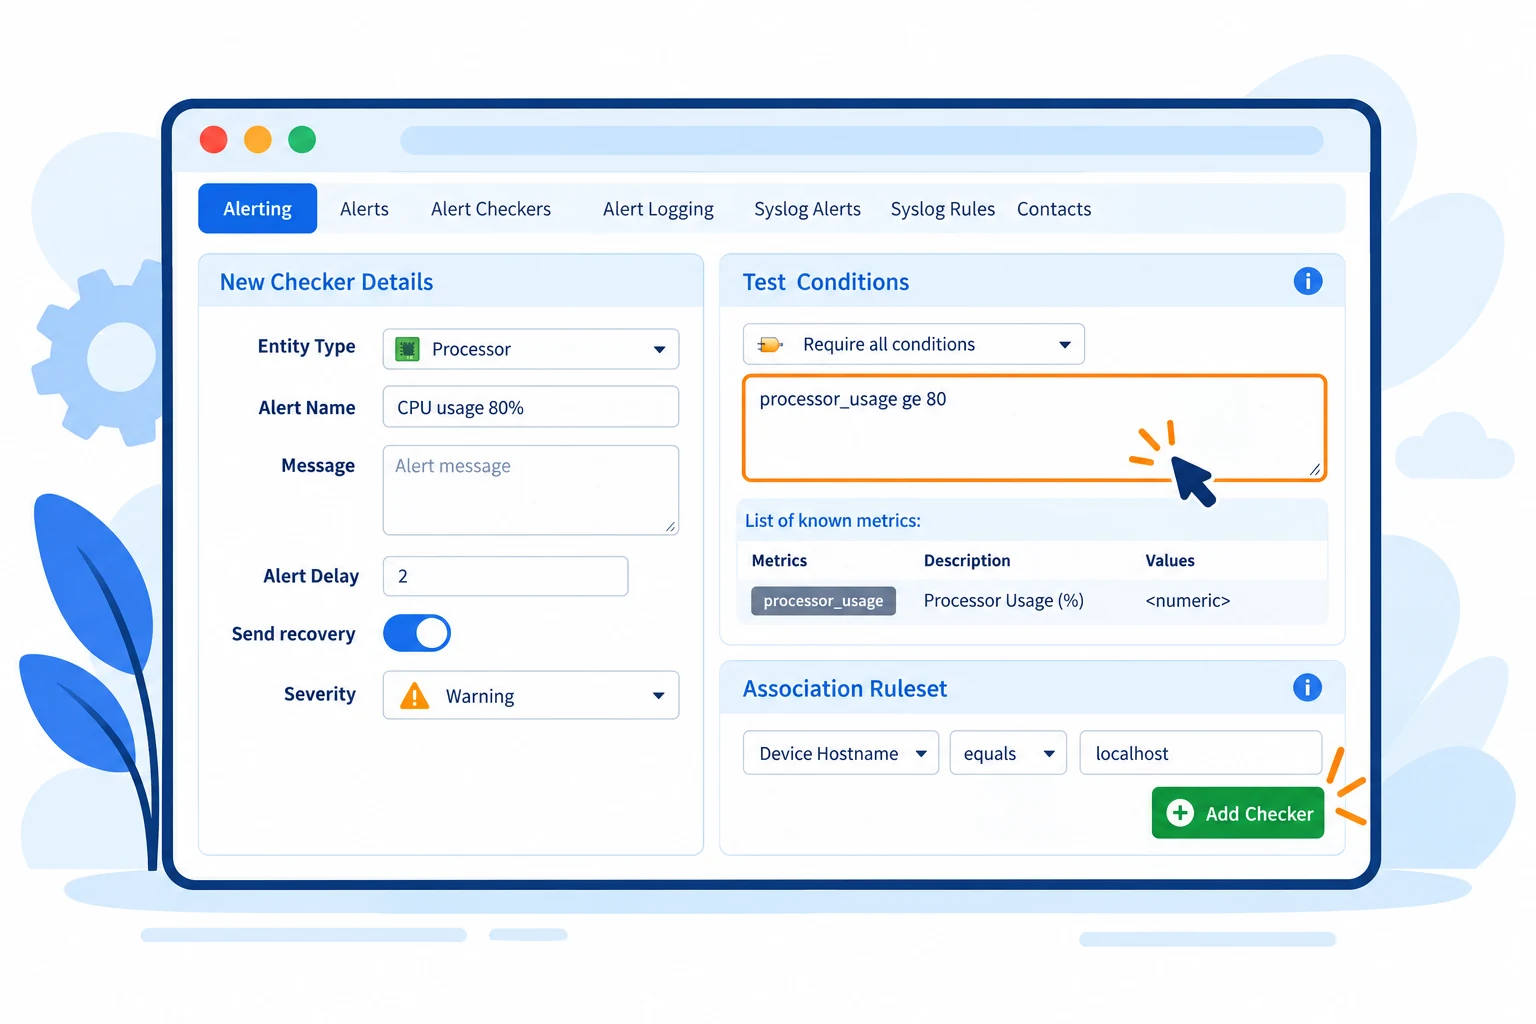
由上方地球圖示選單進入 Alert Checks, 按 Add Checker, 在 Entity Type 選 Processor. 在 Alert Name 填入 CPU usage 80%, Message 可填入收到告警時的處理提示.
Severity 選 Warning, 開啟 Send recovery. Alert Delay 範例填 2, 單位是收集檢查次數, 不是分鐘; 不要把它當成固定 2 分鐘後通知.
 放大圖片
02輸入測試條件並限制監控範圍
在 Test Conditions 輸入以下內容, 保留英文欄位名稱與半形空格:
processor_usage ge 80processor_usage ge 80 表示使用率大於或等於 80%. 保持 Require all conditions. 門檻應配合平時負載調整, 避免把短暫的正常工作量當成故障.
在 Association Ruleset 選 Device Hostname / equals / localhost. 此設定會納入該設備的 Processor 項目. 只想監控平均值時, 再按 Add rule 加上 Processor Description / equals / Average, 並使用 AND; 需先確認你的設備有這個項目.
放大圖片
03建立規則並核對結果
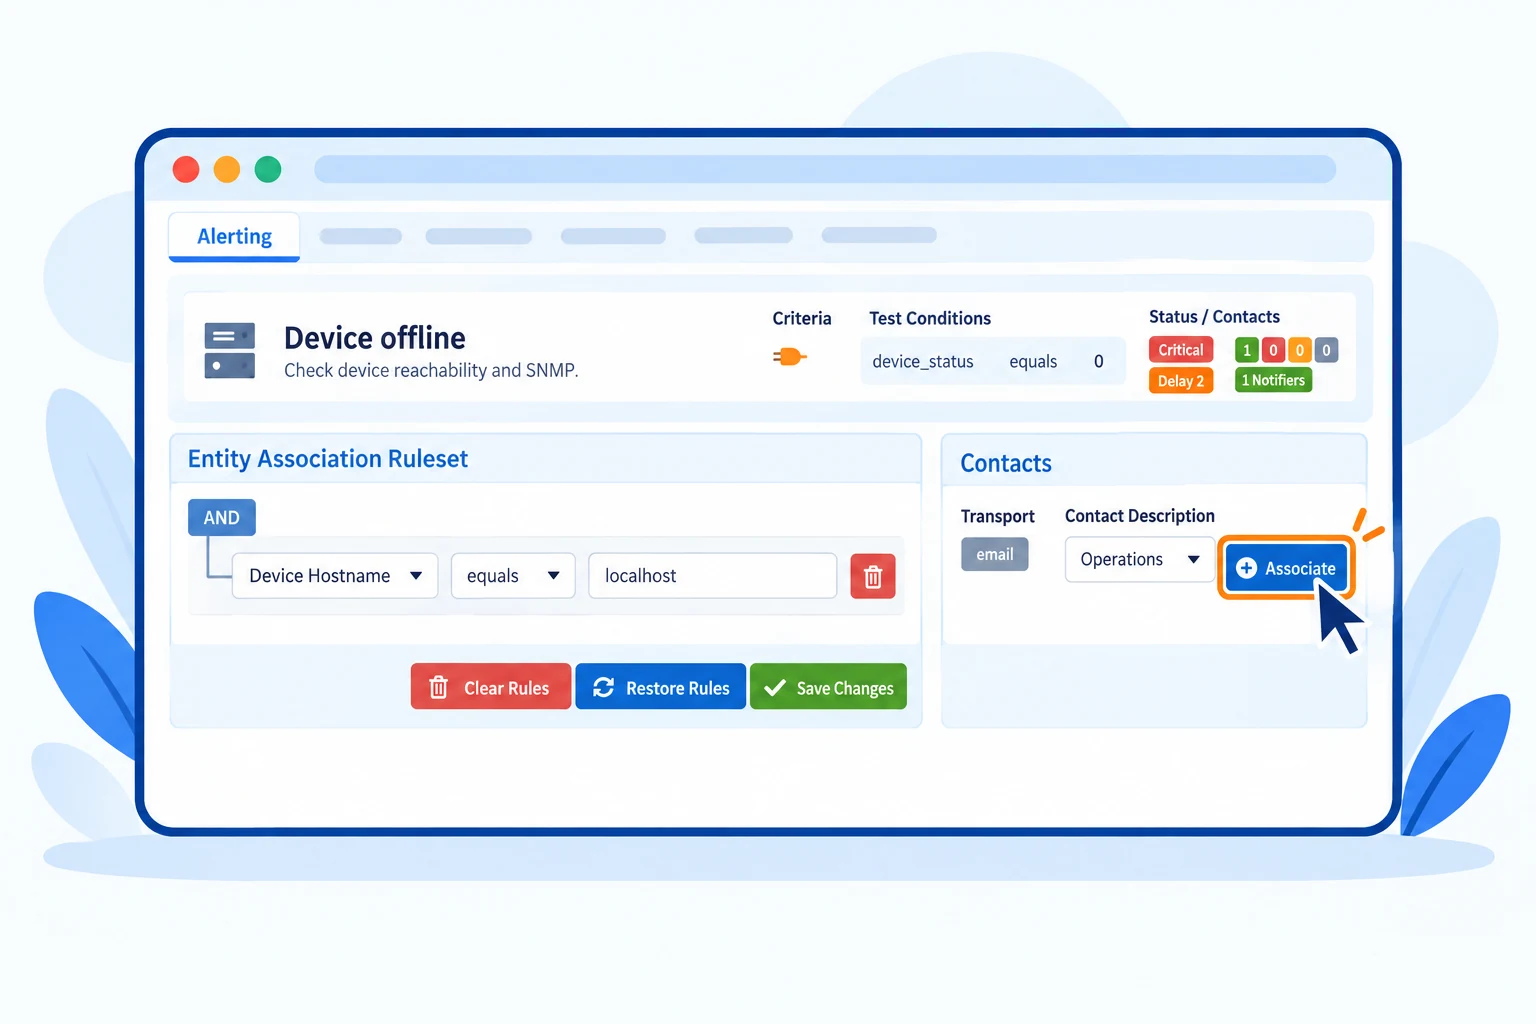
按 Add Checker, 開啟新規則的 Alert Entries. 確認列出的設備及監控項目正確; 沒有任何項目時先修正範圍, 不代表所有設備正常.
到 Associations 的 Contacts 選取聯絡人並按 Associate. 等待下一次資料收集, 確認 Checked 有更新. 初次顯示 Unknown 或 Never 時, 先等候及核對收集狀態.
已建立的規則可用 Edit Conditions 修改門檻, 用 Edit Check 修改名稱, 延遲及嚴重度, 修改後按 Save Changes. 實際通知仍需完成寄信測試.
 放大圖片
常見問題
只有一個核心很忙也會告警嗎?
若該核心有被收集且包含在規則範圍內, 就會依該項目的使用率判斷. 若只選 Average, 看到的則是平均值. 建立後請檢查 Alert Entries 的每一列.
需要製造主機故障來測試嗎?
不需要. 可在專用測試設備與指定收件人範圍內驗證通知, 並在完成後恢復原始門檻. 不要刻意塞滿硬碟或中斷營運設備. 本系列示範確認規則及異常紀錄, 未進行外部郵件送達測試.